MEDICAL
INSIGHT
“공포 제목이 조회수를 높인다”는 직관을 단순 비교에서 끝내지 않고, 교란변수와 하위집단을 통제해 결론을 다시 검증했습니다.
공포 키워드와 조회수의 음의 관계는 진짜인가, 채널 규모와 영상 나이가 만든 착시인가?
방향은 보였지만 원인은 알 수 없었습니다.
단순 비교에서 공포 키워드를 쓴 의료 영상의 조회수 중앙값은 미사용 영상의 0.78배였습니다(Mann-Whitney p=.033). 방향은 뚜렷했지만, 오래된 영상과 대형 채널이 공포 표현을 더 많이 썼다면 이 차이를 제목 효과라고 결론내릴 수 없었습니다.
분석 단위를 확장하고 교란요인을 수집했습니다.
영상 나이, 채널 구독자 규모, Shorts 여부, 채널 유형을 추가해 공포 키워드와 조회수 사이의 관계를 단계적으로 다시 확인했습니다.
분석 방법마다 다른 질문을 맡겼습니다.
Age adjustment
오래 업로드된 영상이 조회수를 더 많이 누적한 효과를 분리하기 위해 영상 나이를 보정했습니다.
Propensity Score Matching
공포 표현 사용 집단과 미사용 집단의 채널 규모와 영상 특성 차이를 줄였습니다.
Channel fixed effects
채널 고유의 브랜드 영향력을 통제하고 같은 채널 내부에서 제목 표현의 차이를 확인했습니다.
Difference-in-Differences
COVID-19라는 외생적 사건 전후에 공포 표현 효과가 달라졌는지 검토했습니다.
교란을 걷어낼수록 효과는 오히려 또렷해졌습니다.
NAIVE0.78×
AGE ADJ.0.56×
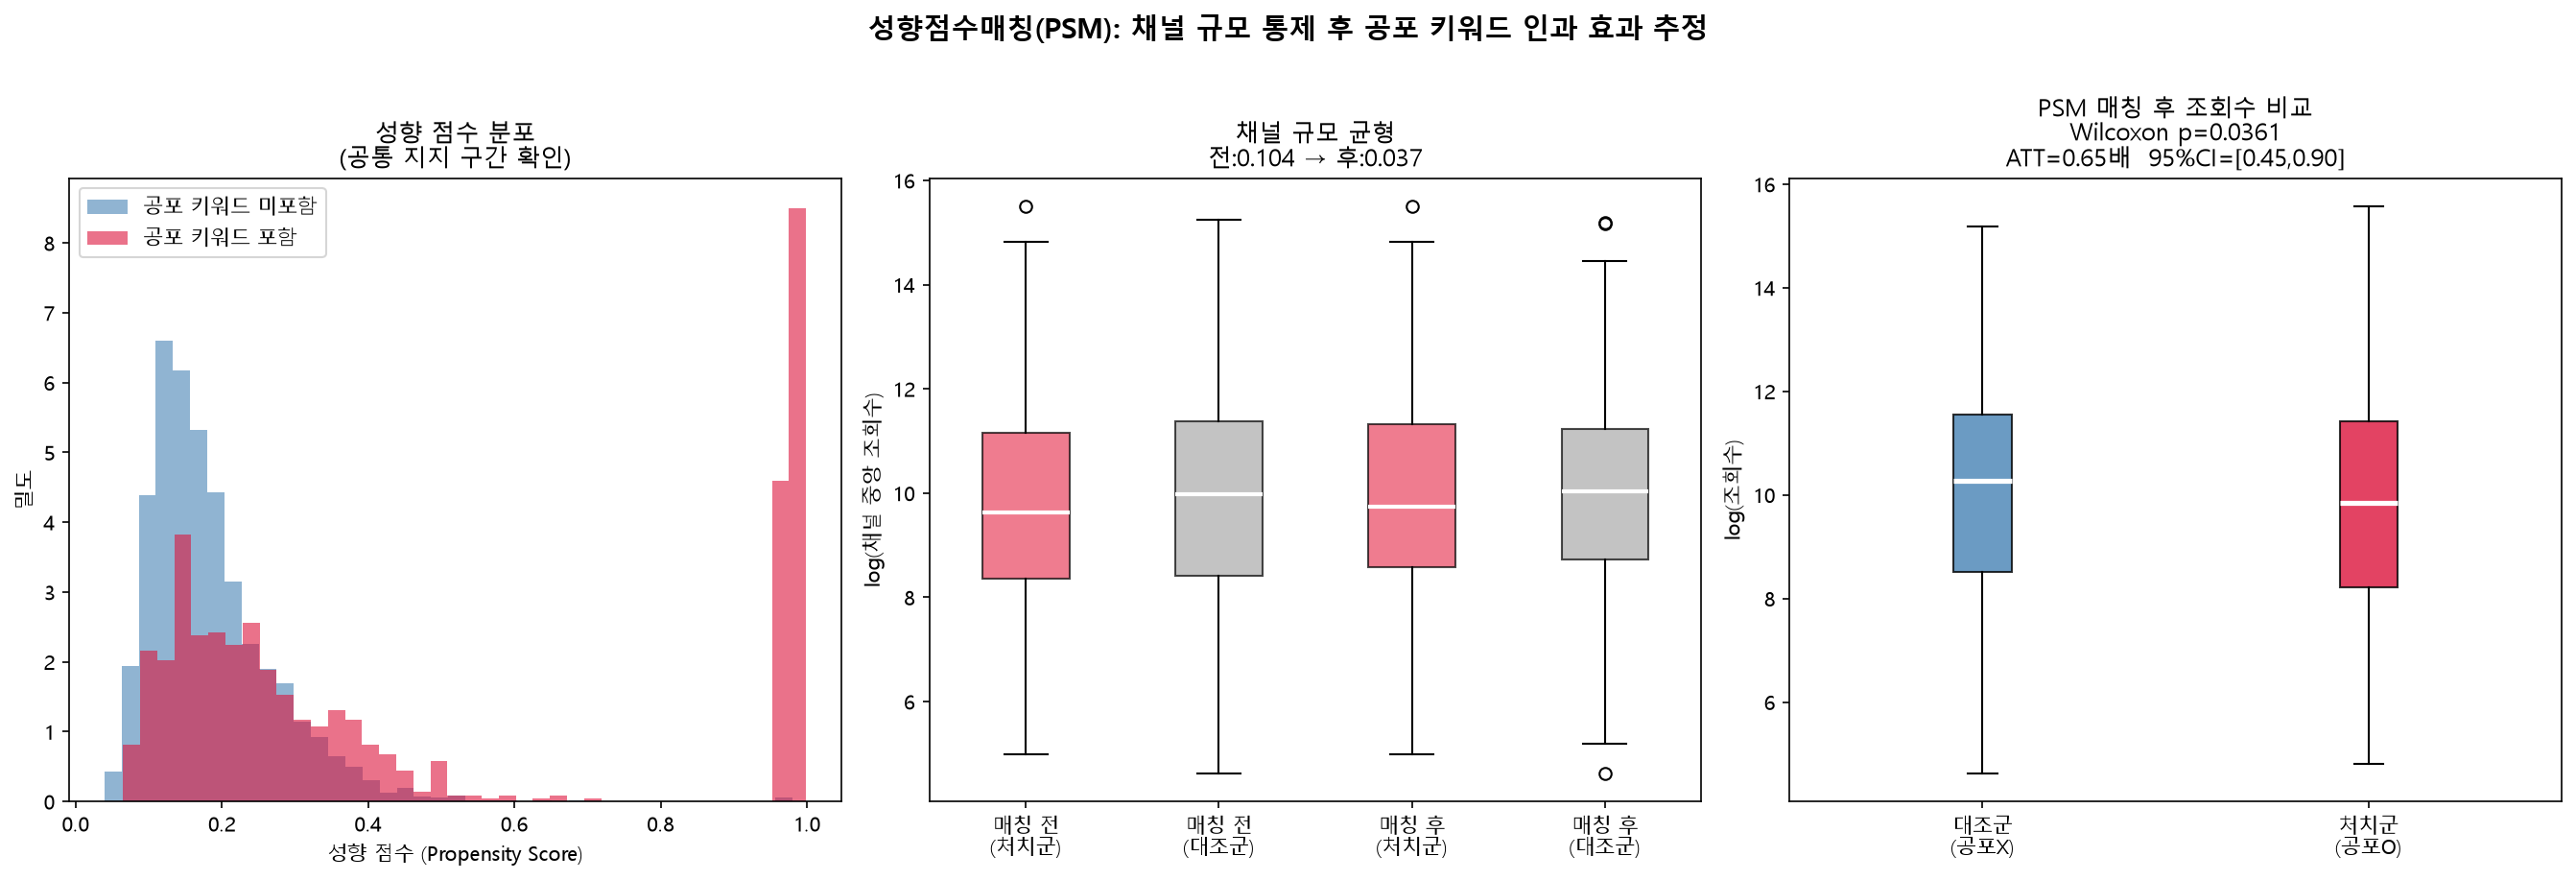
PSM0.65×
세 방법이 같은 방향을 가리키는지가 관건이었습니다.
- 영상 나이를 보정하자(VPD) 0.56배로 오히려 강해짐 (p<.001)
- PSM에서 채널 규모까지 통제한 뒤에도 0.65배로 유지 (95% CI 0.45–0.90, Wilcoxon p=.036)
- 채널 고정효과에서는 같은 채널 내부 효과가 유의하지 않음
- Medical Pro 채널 하위집단에서는 0.83배의 감소 방향
- pre-COVID 표본을 보완한 DiD에서는 +3.4%, 비유의로 수렴해 초기 큰 효과 추정이 표본 부족에 민감했음을 확인
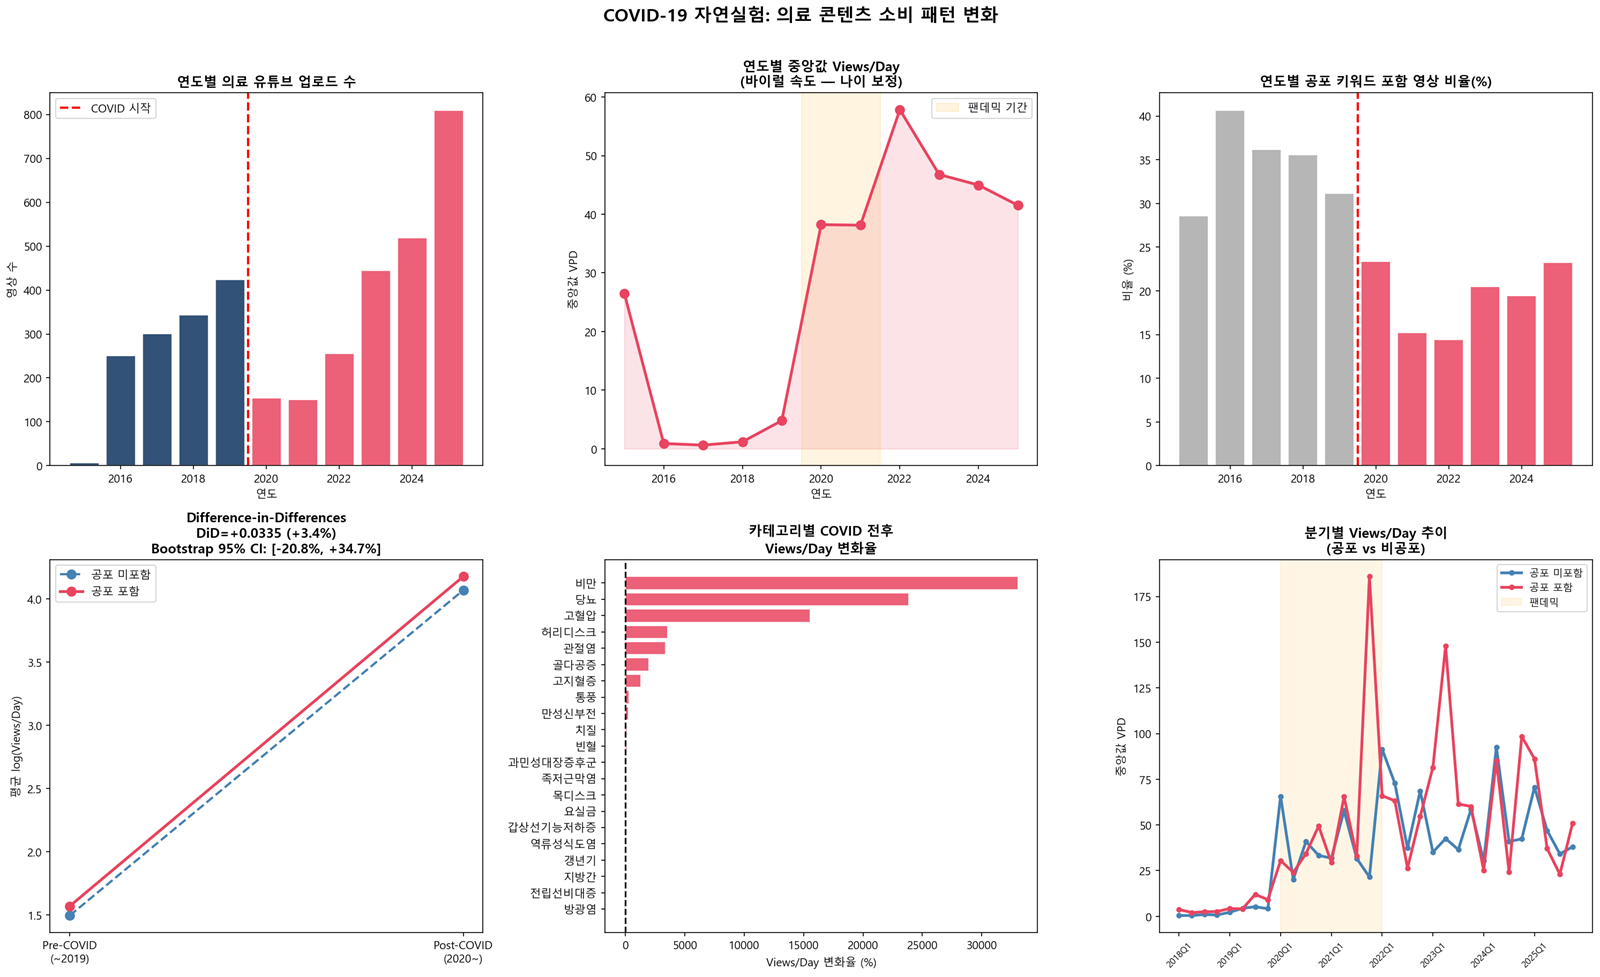
[−20.8%, +34.7%]로 0을 넉넉히 포함합니다. 방향을 주장할 수 없는 구간이므로 “효과 없음”이 아니라 “이 표본으로는 판정 불가”로 남겼습니다.결론뿐 아니라 비교 방식 자체도 다시 검증했습니다.
- PSM 매칭을 logit-scale caliper(0.2 × SD of logit propensity score)로 보강
- 주요 공변량의 매칭 전후 SMD를 재계산해 balance를 수치로 점검 — 채널 규모 0.104→0.037, 영상 나이 0.229→0.013, 제목 길이 0.126→0.035로 기준선 0.1 아래가 됐습니다. 다만 제목의 숫자 포함 여부는 0.037→0.106으로 오히려 기준선을 소폭 넘어 남았습니다
- 성향점수 추정 구현(scikit-learn → numpy)을 바꿔 다시 돌리면 방향은 같지만 배율이 0.65배에서 0.71배로, Wilcoxon p가 .036에서 .068로 달라져, PSM 추정치는 구현에 민감함을 확인했습니다
- 선험적 공포 키워드 목록을 TF-IDF 기반 데이터 검증으로 보완하고, 시간 변화 추적을 위한 panel snapshot collector 추가
인과추론도 관찰 데이터의 한계를 넘지는 못합니다.
댓글 수집 범위, 측정되지 않은 교란변수, Shorts 추천 알고리즘, PSM 매칭 후 외적 타당성의 제한을 함께 기록했습니다. 결과는 “모든 의료 채널에서 공포 표현이 항상 역효과”라는 주장이 아니라, 단순 상관관계의 해석이 위험하다는 근거로 제한했습니다.
숫자가 어느 분석에서 나왔는지부터 다시 확인했습니다.
이전 분석의 수치가 남은 문서
증상 분석을 다시 돌린 뒤에도 문서 다섯 곳에 이전(v1) 데이터의 수치가 남아 있었습니다. 해결 현재 데이터로 다시 계산해 단순 비교·나이 보정 수치를 정정하고, 커밋에 “v1 잔재이며 v2 결과가 아님”이라고 명시했습니다.
같은 숫자라도 어떻게 비교했는지가 결론을 정합니다.
설득력 있는 수치보다 올바른 비교 대상을 만드는 과정이 중요하다는 점, 그리고 한 가지 방법의 결과를 결론으로 삼지 않고 여러 설계가 같은 방향을 가리키는지 확인해야 한다는 점을 배웠습니다.
Streamlit Community Cloud는 접속이 없으면 앱을 재웁니다. 잠들어 있으면 첫 화면에서 “Yes, get this app back up!”을 누르고 1분쯤 기다리면 기동합니다.